
Die Grundlagen stehen. In den letzten Monaten haben wir Schritt für Schritt genau das gebaut, getestet und gehärtet, worauf es bei meteoCORE ankommt:
- Die volle Bandbreite an Dateneingängen: In der Wetterdatenwelt gleicht kaum eine Quelle der anderen. Wir haben inzwischen den überwiegenden Teil dessen angebunden, was die Praxis an Besonderheiten fordert: etliche verschiedene Wettermodelle mit ihren jeweils eigenen Gittern und Formaten, unterschiedlichste Radarquellen samt Rohdatenverarbeitung sowie diverse Messnetze mit völlig uneinheitlicher Sensorik und Meldeintervallen.
- Robuste Verarbeitung & eigene Ableitungen: Das Backend nimmt diese heterogene Datenflut nicht nur entgegen, sondern homogenisiert, rechnet und generiert daraus verlässliche, eigene abgeleitete Produkte – schnell, fehlertolerant und kontinuierlich.
- Proof-of-Concept im Frontend – mit minimaler Latenz: Dass diese Datenmengen nicht nur auf der Festplatte liegen, sondern sich extrem flüssig analysieren lassen, beweist unser meteoCORE Navigator. Dank moderner Frontend-Technik laufen selbst hochaufgelöste Vektor- und Rasterebenen ohne Hakeln direkt im Browser. Und das Entscheidende: Die Pipeline ist auf minimale Latenz getrimmt. Wenn eine Wetterstation einen Messwert sendet, vergehen oft nur wenige Sekunden, bis der Punkt fertig prozessiert und live im Navigator sichtbar ist. Vom Sensordaten-Eingang bis zur Visualisierung vergeht praktisch keine spürbare Zeit.
Damit ist der Beweis erbracht: Die Kette funktioniert – von der Datenaufnahme über die Veredelung bis zur sekundenschnellen Darstellung.
Wer allerdings eine zukunftsfähige meteorologische Dateninfrastruktur für den echten 24/7-Einsatz aufbauen will, darf nicht auf manuell gewachsenen Systemen stehenbleiben. Ein Setup, das man von Hand pflegen oder im Ernstfall mühsam rekonstruieren muss, skaliert nicht. Deshalb haben wir den nächsten logischen Schritt umgesetzt: Alles, was wir bisher aufgebaut und getestet haben, ist ab sofort vollständig als Code definiert und automatisiert.
Infrastructure as Code: Vom manuell aufgesetzten Node zum reproduzierbaren System
Was in der ersten Entwicklungsphase noch punktuell per Hand konfiguriert wurde, folgt jetzt strengen Automatisierungsstandards:
- Vollautomatischer Rollout mit Ansible
Vom nackten Basis-Betriebssystem über die Docker-Umgebungen bis zur feinen Systemkonfiguration: Neue Compute-Nodes werden vollständig per Ansible-Playbook aufgesetzt. Kein manuelles Klicken, keine vergessenen Konfigurationsdateien – jeder Server ist zu 100 % reproduzierbar. - Privates Mesh-Netzwerk via meteoSCALE
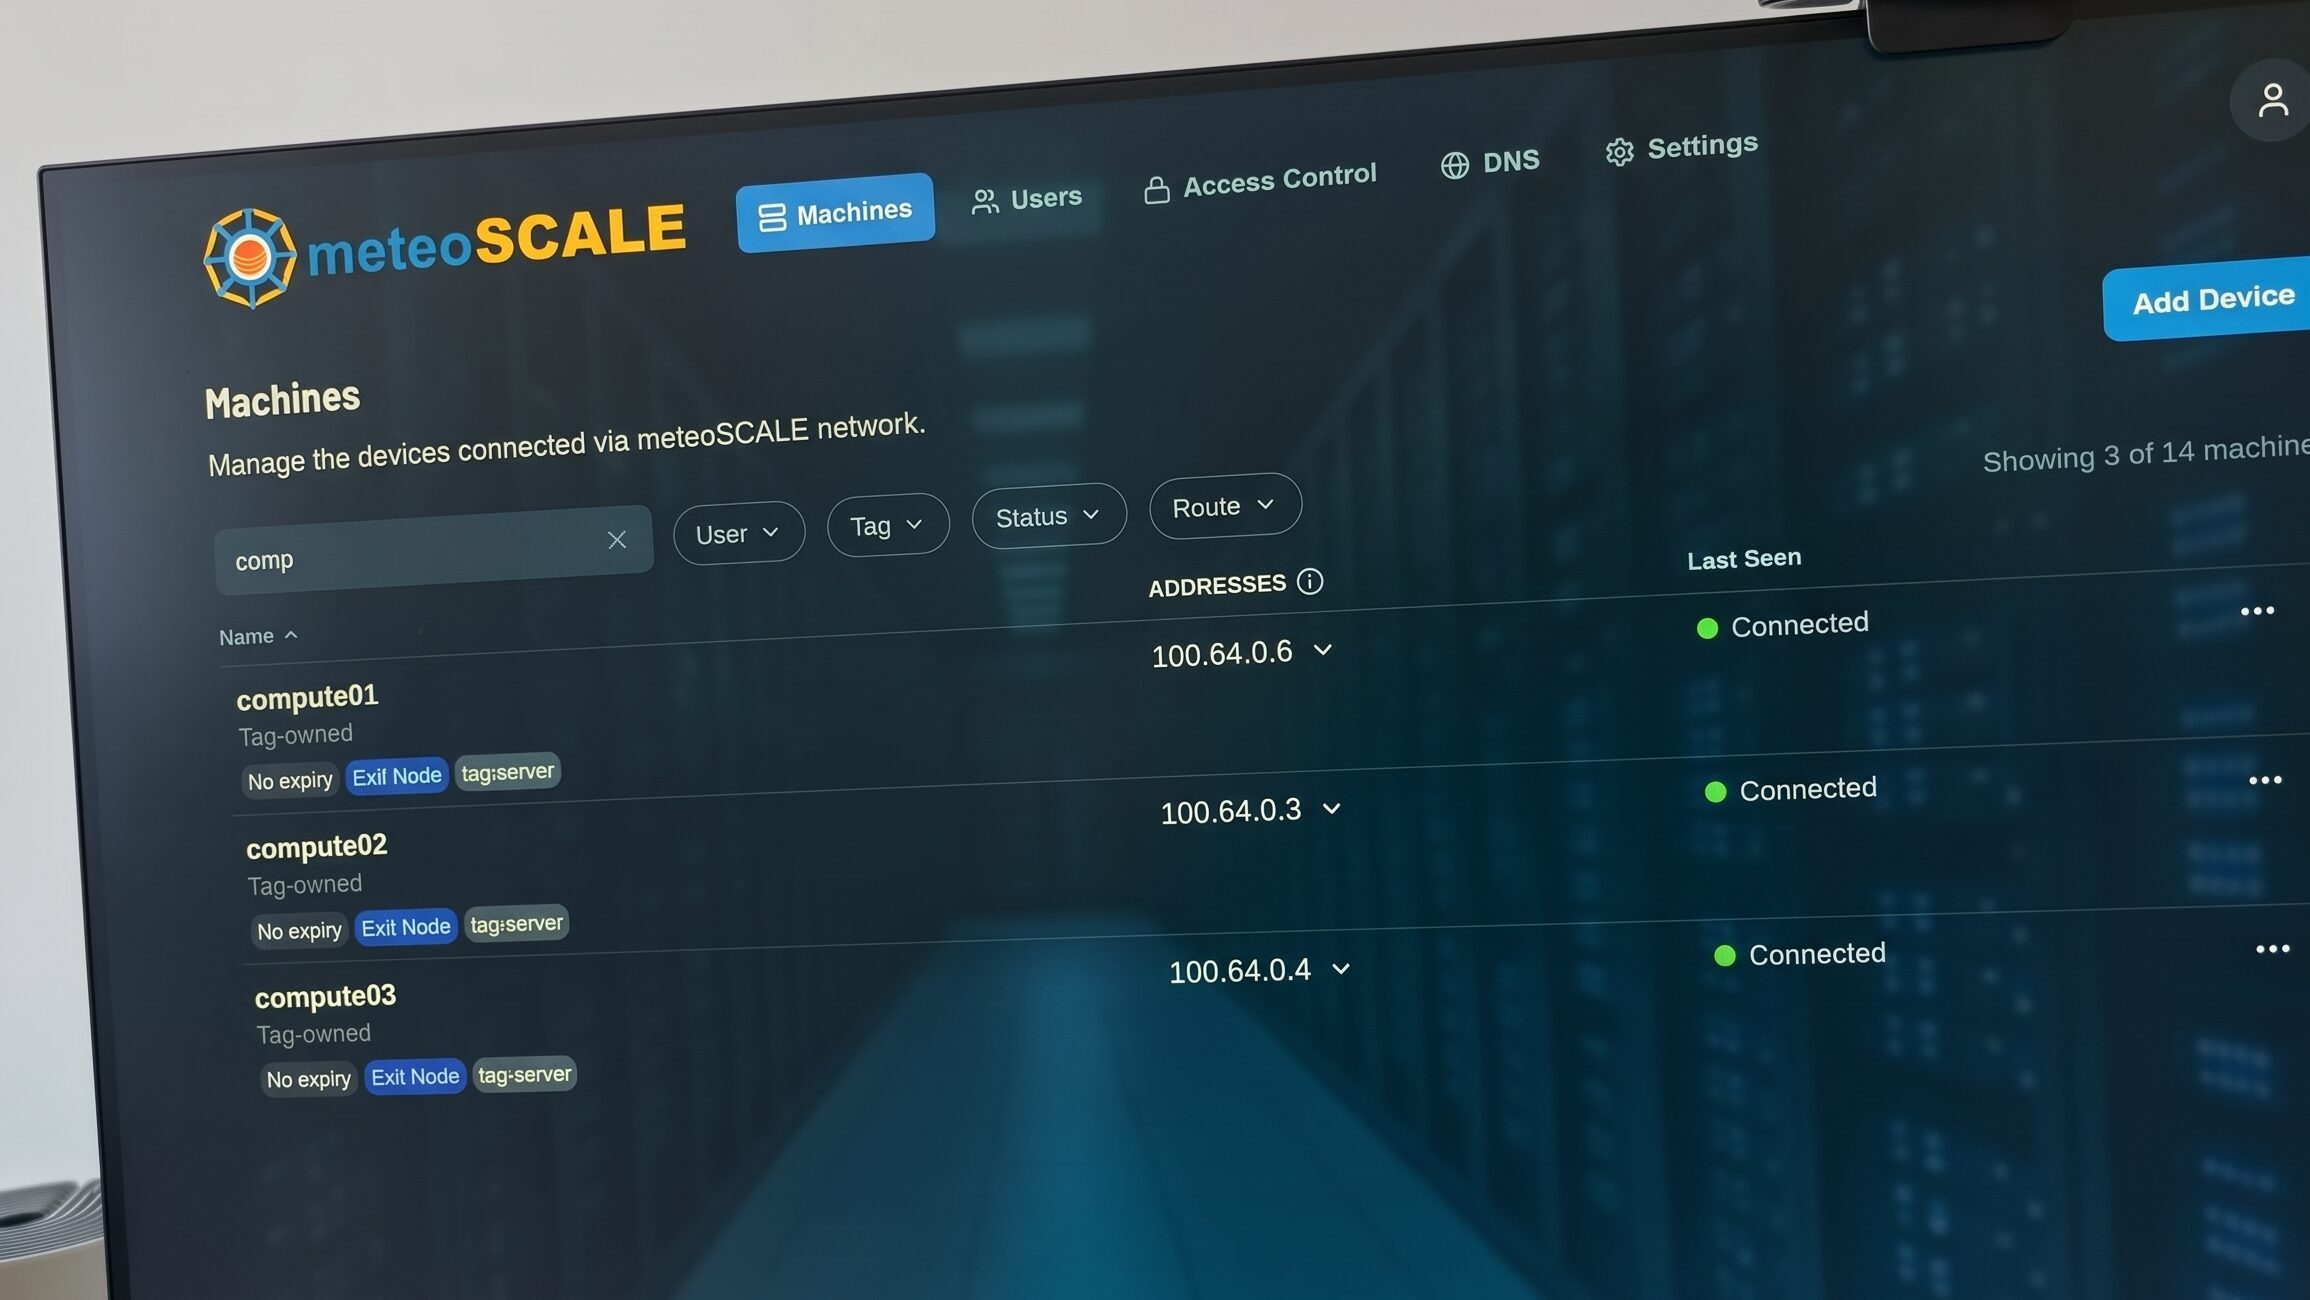
Unsere Server kommunizieren provider-übergreifend über ein abgesichertes, privates WireGuard-Mesh (meteoSCALE). Egal, wo eine Maschine physisch steht: Für unsere Dienste und Datenpipelines verhält sich die gesamte Infrastruktur so, als stünden alle Rechner gemeinsam im selben Serverschrank. - Verschlüsseltes Restic-Backup auf deutschem S3-Storage
Auch bei der Datensicherung machen wir keine Kompromisse: Konfigurationen und persistente Daten sichern wir verschlüsselt mit Restic auf unabhängigen S3-Objektspeichern – gehostet von einem deutschen Provider in deutschen Rechenzentren. Zero-Knowledge-Verschlüsselung, volle digitale Souveränität, kein US-Cloud-Lock-in. - Disaster Recovery: Getestet, nicht nur gehofft
Ein Backup existiert erst dann, wenn der Restore erprobt ist. Durch das Zusammenspiel aus Ansible-Playbooks und deterministischen Restic-Snapshots können wir jeden beliebigen Knoten binnen kürzester Zeit an jedem beliebigen Standort neu aufsetzen und den Betrieb nahtlos wieder aufnehmen.
Das Fundament für das, was kommt
Damit ist meteoCORE technisch dort, wo ein modernes Daten-Startup sein muss: Wir können neue Rechenkapazität in Minuten hochfahren, wenn zusätzliche Wettermodelle dazukommen oder Lastspitzen anstehen.
Die Hausaufgaben auf Systemebene sind erledigt – die Infrastruktur ist zukunftsfähig aufgestellt. Jetzt konzentrieren wir uns auf die nächsten Funktionen.